Ultra-Fast AI Inference at 10 GSPS Detects Particle Pile-Up in Real Time
An FPGA-based CNN localizes every particle in the spill at GSI/FAIR with 300 ns latency while processing 120 Gbit/s, even when detector pulses overlap.
www.spdevices.com
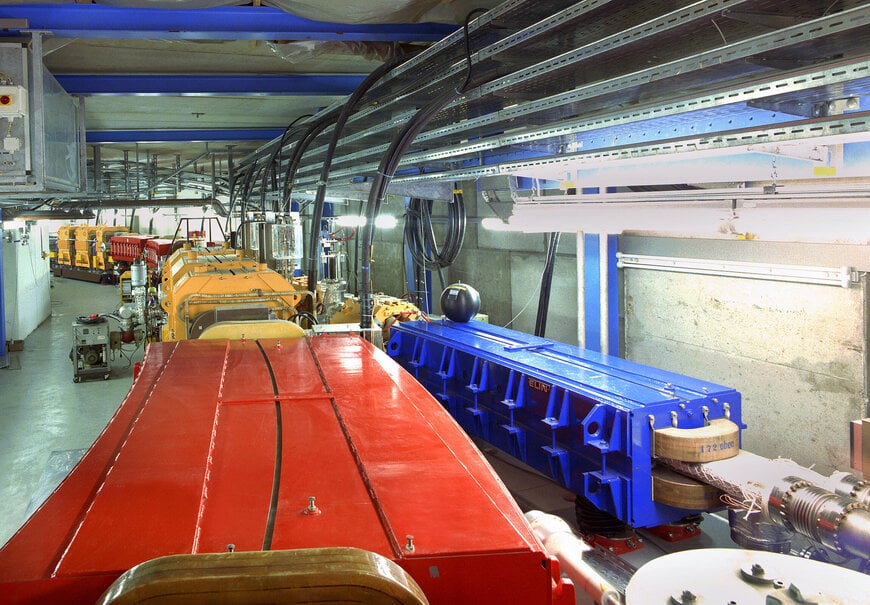
L'inferenza AI basata su FPGA a 10 giga-campioni al secondo (GSPS) sul Teledyne ADQ35 consente una localizzazione affidabile e accurata delle particelle presso il GSI Helmholtzzentrum für Schwerionenforschung di Darmstadt, Germania, in tempo reale, con una latenza inferiore al microsecondo e una risoluzione temporale inferiore al nanosecondo, anche in presenza di elevati tassi di particelle e di una significativa sovrapposizione dei segnali. Il lavoro è stato svolto nell'ambito di una ricerca di dottorato presso la Hochschule Fulda - University of Applied Sciences in collaborazione con il GSI. Una rete neurale convoluzionale (CNN) implementata direttamente sull'hardware FPGA elabora 120 gigabit di dati al secondo con una latenza di appena 300 nanosecondi.
Contare ogni particella nello spill
Gli acceleratori di particelle producono fasci di particelle controllati con precisione per esperimenti scientifici, ricerca sui materiali e applicazioni medicali. Al GSI, il sincrotrone SIS18 accelera le particelle nell'anello dell'acceleratore e successivamente invia il fascio agli esperimenti estraendo le particelle dal fascio stesso, nel cosiddetto spill. Per il controllo dello spill, è essenziale sapere quante particelle sono presenti nello spill e come sono distribuite nel tempo. A tal fine, ogni particella nello spill deve essere localizzata in tempo reale durante il funzionamento dell'acceleratore, un compito particolarmente impegnativo nell'ambito della strumentazione per fasci di particelle.
Un rivelatore viene posizionato nel fascio ed emette un impulso per ogni particella che lo attraversa. Questo è illustrato nella Figura 1. Se più particelle attraversano il rivelatore in un intervallo di tempo molto breve, gli impulsi si sovrappongono e la risposta del rivelatore può diventare non lineare. Questo fenomeno di sovrapposizione degli impulsi è chiamato pile-up e la sua probabilità aumenta all'aumentare dell'intensità del fascio. Se gli eventi di pile-up non possono essere risolti correttamente, devono essere evitati, limitando così l'intensità del fascio.
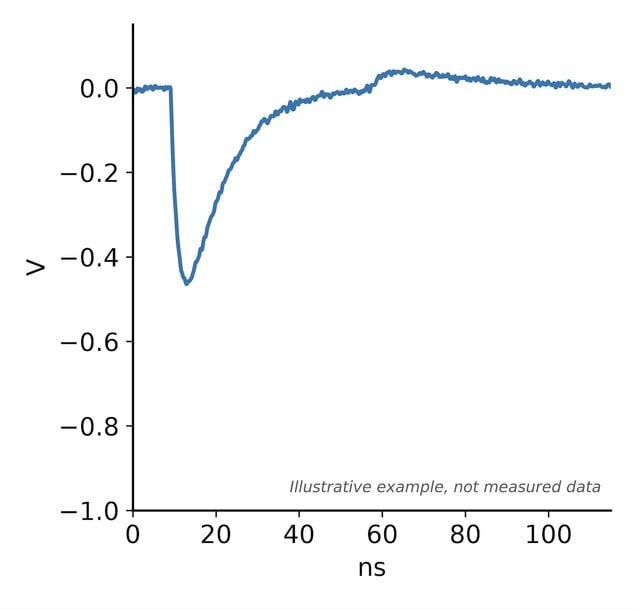
Figura 1. L'impulso generato quando una particella colpisce il rivelatore.
La Figura 2 mostra quattro esempi di questo fenomeno di pile-up. Ogni esempio mostra la risposta del segnale quando tre particelle arrivano in un breve intervallo di tempo. Il tempo di arrivo di ciascuna particella è indicato da una linea verde tratteggiata.
I metodi tradizionali, come il rilevamento multi-soglia o la ricerca dei massimi locali, incontrano difficoltà e spesso non riescono a rilevare le particelle quando si verifica un pile-up. Questo porta a un conteggio inferiore al numero effettivo di particelle, con possibili conseguenze negative per il controllo dello spill e per gli esperimenti successivi.
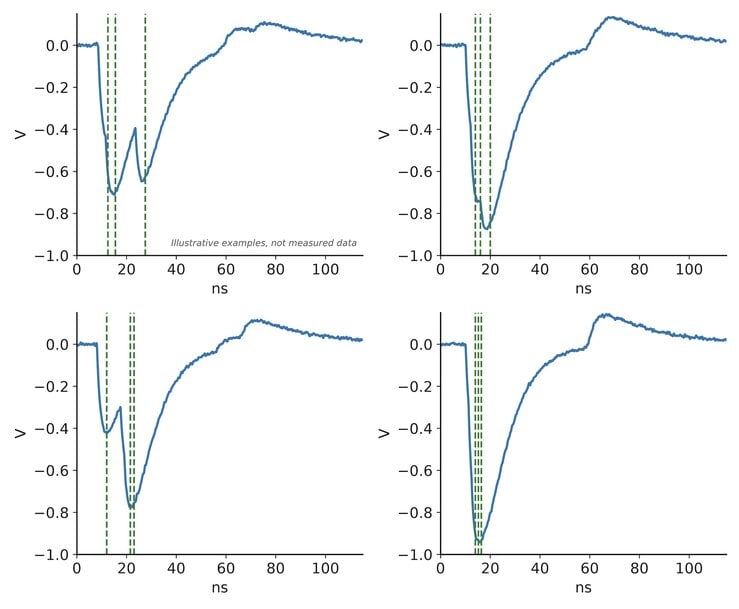
Figura 2. La risposta del rivelatore quando più particelle arrivano in un breve intervallo di tempo. Tre particelle arrivano e i relativi impulsi si sovrappongono.
Elaborazione dei segnali basata sull'AI su FPGA
Per affrontare questa sfida, è stata sviluppata e addestrata una CNN su dati etichettati. Successivamente, la rete è stata implementata direttamente sull'hardware FPGA utilizzando una toolchain sviluppata da UFAIRA.
Il modello AI localizza ogni singolo impulso, anche in presenza di pile-up, ricavando in tempo reale sia il numero di particelle sia le informazioni relative al tempo di arrivo. Ciò consente di ricostruire con precisione lo spill anche a velocità molto elevate. L'implementazione della CNN su FPGA elabora i dati inline e garantisce una latenza deterministica, aspetto particolarmente importante per applicazioni in tempo reale come il controllo dello spill.
Implementazione sul digitalizzatore
La soluzione è realizzata utilizzando il digitalizzatore ad alta velocità Teledyne SP Devices ADQ35, con frequenze di campionamento fino a 10 GSPS e un FPGA AMD Kintex UltraScale KU115 integrato. Ciò mette a disposizione notevoli risorse di calcolo per l'inferenza AI in tempo reale direttamente sul digitalizzatore. Elaborando i dati direttamente sul digitalizzatore, il sistema evita i colli di bottiglia nel trasferimento dei dati e consente un funzionamento con una latenza inferiore al microsecondo.
Utilizzando una toolchain per l'addestramento e l'implementazione della CNN, ottimizzata per FPGA e basata sui vincoli hardware, la CNN implementata può elaborare 32 campioni in parallelo a 312,5 MHz, raggiungendo 10 GSPS, con una latenza ridotta e deterministica e un'elevata accuratezza.
300 ns di latenza a 120 Gbit/s
La CNN implementata raggiunge una latenza di appena 300 nanosecondi, elaborando 120 gigabit al secondo (10 GSPS, con 12 bit per campione). Utilizza meno del 15% delle risorse DSP disponibili e meno del 6% delle risorse LUT disponibili sull'FPGA, lasciando quindi ampio spazio per modelli ancora più grandi o per puntare a un throughput superiore.
L'approccio basato sull'AI migliora significativamente le prestazioni in condizioni di pile-up e supera i metodi tradizionali, come il rilevamento multi-soglia e la ricerca dei massimi locali. La CNN localizza i singoli impulsi negli eventi di pile-up con un'affidabilità tale da non rendere più necessario evitare il pile-up riducendo il tasso di particelle. Ciò consente al sistema di operare a tassi di particelle molto più elevati senza richiedere modifiche all'hardware del rivelatore.
Quando è utile l'AI nell'elaborazione dei dati ad alta velocità in tempo reale?
Sulla base di questo esempio, l'AI diventa particolarmente rilevante quando più eventi si verificano nello stesso intervallo di tempo e producono un segnale sovrapposto. L'AI può inoltre essere utile quando l'elaborazione del segnale è troppo complessa per i metodi tradizionali o quando la forma dei segnali varia a causa di effetti reali come deriva, rumore e non linearità. I modelli AI possono apprendere comportamenti complessi dei segnali ed estrarre informazioni difficili o impossibili da recuperare in tempo reale con i metodi tradizionali.
L'approccio qui dimostrato è ampiamente applicabile ai settori dei dati ad alta velocità che richiedono elaborazione inline a bassa latenza, tra cui il monitoraggio dello spettro in tempo reale e la classificazione dei segnali, la stima dei canali nei sistemi RF, il trading ad alta frequenza, il rilevamento delle intrusioni nelle reti, l'elaborazione delle immagini per sistemi autonomi e molto altro.
Informazioni su UFAIRA
I metodi e la toolchain utilizzati in questa ricerca costituiscono oggi la base di UFAIRA, un'azienda che sviluppa acceleratori AI basati su FPGA personalizzati per l'inferenza in tempo reale, fondata nel 2026 come spin-off della ricerca di dottorato presso la Hochschule Fulda - University of Applied Sciences.
Maggiori informazioni: https://ufaira.eu/?utm_source=mepax
Informazioni su Teledyne SP Devices
Teledyne SP Devices è un'azienda pioniera nell'acquisizione di dati ad alta velocità, che offre digitalizzatori avanzati e soluzioni per l'elaborazione dei segnali destinate ad applicazioni complesse in tutto il mondo. Grazie a una lunga storia di innovazione, che include un ruolo pionieristico nello sviluppo della tecnologia dei digitalizzatori a 10 GSPS, aiutiamo i clienti ad acquisire ed elaborare i dati in modo più rapido, accurato ed efficiente.
Maggiori informazioni: https://www.spdevices.com/en-us?utm_source=mepax